AIデータセンターの電力制限が後押し、光コンピューティングが急成長
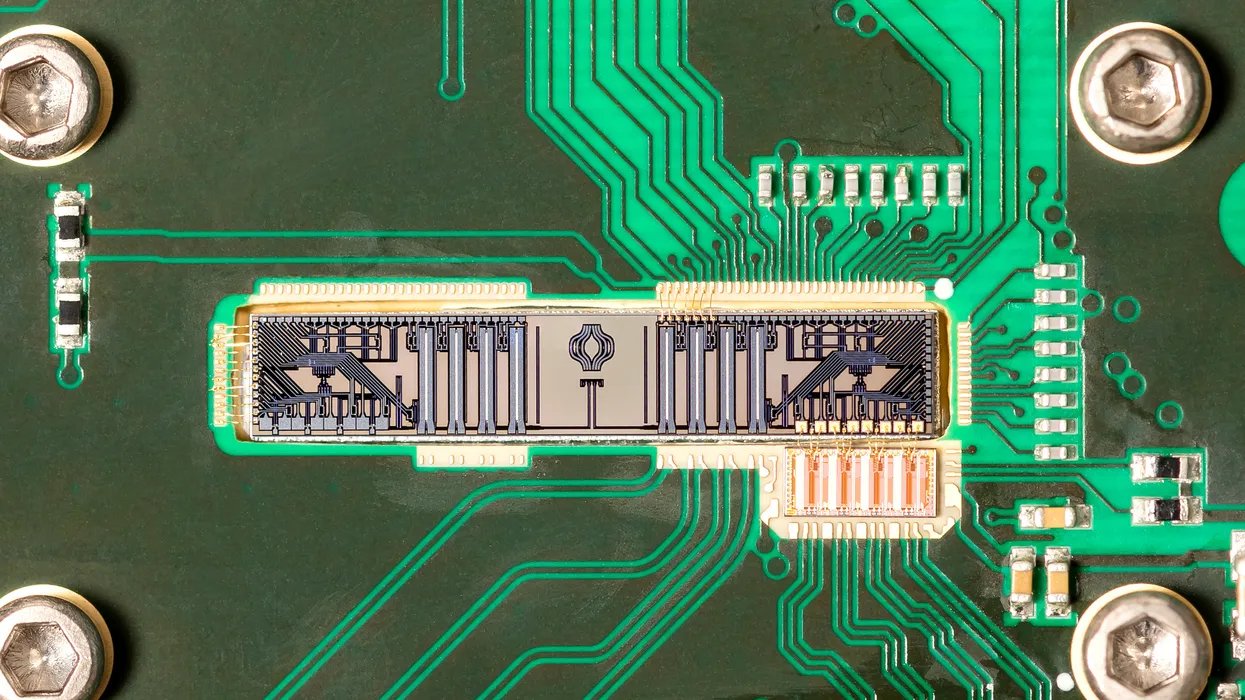
エグゼクティブ・サマリー // 主要ポイント
- •AI推論の電力需要急増により、消費電力を大幅に抑制できる光コンピューティング技術への投資が急加速し、関連セクターの評価額は22億2000万ドルに到達した。
- •物理学的な利点(光子の線形演算)を生かし、従来のGPUと比較して桁違いのエネルギー効率を実現する手法として、空間伝播方式とシリコンフォトニクス集積回路の2つのアプローチが競合している。
- •完全なGPU代替ではなく、特定計算(行列演算、フーリエ変換等)を光プロセッサが担う「異種混在型コンピューティング」が、将来のデータセンターの標準形態になると予測されている。
ニューヨーク — 人工知能(AI)ワークロードを稼働させる世界のデータセンターで深刻な電力ボトルネックが発生していることを背景に、光コンピューティングの商業的復活が加速している。スタートアップや研究機関が電気回路を光に置き換える技術開発を競う中、関連セクターの評価額は22億2000万ドルに達した。
IEEE Spectrumの報告書によると、2022年には4億ドルだった資本流入が急増しており、従来のシリコン製グラフィックス・プロセッシング・ユニット(GPU)がAI推論時に物理的なエネルギーの限界に直面しているとの認識が業界で高まっている。生成AIモデルのクエリ処理に莫大な電力を消費するサーバークラスターを抱える企業オペレーターや半導体設計者は、電子抵抗を回避する手段としてフォトニクス(光工学)に着目しており、エネルギー消費量と運用コストを桁違いに削減することを目指している。
電力ボトルネックの中で復活する「グッドマン・モデル」
光を用いた計算という概念は70年以上前から存在するが、AI推論に対する爆発的な需要が電力網の限界に突き当たるまで、商業的な実現可能性は未知数だった。現代のニューラルネットワークの核心にあるのは、毎秒数十億回実行されるベクトル行列演算である。標準的な電子回路では、長さNのベクトルとN×Nの行列の積を計算するためにNの2乗の個別演算が必要となり、それぞれが熱エネルギーを放出する。対照的に光アーキテクチャでは、光が光減衰器や変調器をパッシブ(受動的)に通過するため、入力のエンコードと出力の読み取りにのみ電力を必要とし、エネルギー消費はNに対して線形でスケールする。
この物理学上の根本的な利点が、学術界およびベンチャー界の関心を再燃させている。1978年、光コンピューティングの先駆者であるジョセフ・W・グッドマンは、発光ダイオード、レンズ、減衰器を用いて行列演算を実証した。今日では、最新の微細加工技術とレーザーシステムにより、この実験室レベルのコンセプトがスケーラブルなエンジニアリングの提案へと進化している。
「[フォトニクス]への関心の大部分は、AI推論が文字通り電力によって制限されるようになり、それも極めて顕著な形で起きているという事実に端を発しています」と、10年以上にわたり光コンピューティングを研究しているコーネル大学のピーター・マクマホン准教授(応用・工学物理学)は指摘する。
2022年、マクマホン氏率いるコーネル大学の研究チームは、1回の演算あたり約2.5×10^-19ジュール(1光子未満のエネルギーに相当)を消費する光ニューラルネットワークを実証した。比較対象となる標準的なデジタルコンピュータの消費電力は演算1回あたり10^-14〜10^-12ジュールであり、理論上は最大10万倍の効率向上が示唆される。ただし、マクマホン氏はデータ符号化のオーバーヘッドやアムダールの法則が実際の性能向上を抑制することに留意し、光システムで電気データを光に変換するエネルギーコストを上回るには、一般的に1,000〜10,000要素のベクトル長が必要になると警告している。
アーキテクチャの分断:空間伝播方式とシリコンフォトニクス集積回路
現在、米国、英国、ドイツ、中国、イスラエルにおける商業化の取り組みは、「空間伝播方式」と「シリコンフォトニクス集積回路」という2つの設計哲学に二分されている。
空間伝播方式の陣営では、オックスフォードを拠点とするスタートアップのLumaiが、導波路損失を回避するために空間光変調器(SLM)をオープンエアで実装している。Lumaiは、プロンプトトークンをメモリに取り込む推論の「プリフィル(Prefill)」段階という演算負荷の高いフェーズをターゲットとしている。プロダクト責任者のフィリップ・バー氏は、2026年4月に評価予定のサーバー「Iris Nova」が概念実証の役割を担い、次世代機の「Iris Aura」は標準的なGPUの約10分の1の電力でプリフィルワークロードを実行することを目指すと語った。
テキサス州オースティンのハードウェア開発企業Neurophosは、エンジニアリングされたメタマテリアルを用いて波長以下のスケールで空間操作を行う手法を追求している。Neurophosのパトリック・ボーエン最高経営責任者(CEO)によれば、従来のシリコンフォトニクス変調器は2ミリメートルに及ぶことがあり、台湾積体電路製造(TSMC)のような最先端のファウンドリと比較してチップ上の計算密度が制限される。ボーエン氏のチームは、液晶ディスプレイよりも1万倍高速に切り替え可能なマイクロメートルスケールのメタマテリアル変調器を開発し、5ミリメートルのチップに100万個をパッケージングすることに成功した。同社は2028年に商用サーバーラックの提供を計画しており、NVIDIAのBlackwell B200アクセラレータと比較して50倍高速かつ35倍のエネルギー効率を目標に掲げている。
対照的に競合他社は、空間の3次元的スケーリングを捨て、既存の半導体ファウンドリの量産ラインを活用できるシリコンフォトニクス集積回路に注力している。
「空間光学が通常、年間1,000台の生産に制限されるのにはもっともな理由があります」と、シュトゥットガルトに拠点を置くQ.ANTのミヒャエル・フェルトシュCEO兼創業者は述べる。「半導体製造可能な集積フォトニック回路の方が、現時点では量産化への道のりがはるかに有望です」
Q.ANTは、チップ上のマッハツェンダー干渉計を通過するシリアル光パルスを利用し、ライブニッツ・スーパーコンピューティング・センターやユーリッヒ・スーパーコンピューティング・センターなどの研究拠点に「Native Processing Server」を展開しているほか、欧州のクラウドホストであるIonosとも商用展開を行っている。中国では、上海を拠点とするLightelligenceが統合光学プロセッサ「PACE2」を実証済みであり、1GHzのクロック周波数で128×128の行列演算を3ナノ秒のレイテンシで実行し、従来のシリコンチップを2桁上回る性能を示した。
代替アーキテクチャと異種混在型データセンターのロードマップ
光ハードウェア開発者は、従来のベクトル行列代数を超えて、光子がデジタル論理ゲートよりも本質的な計算上の利点を持つ数学的演算に照準を合わせている。
フーリエ変換のような演算は、数百の電子トランジスタを使用する代わりに、単一の受動的な光学素子を用いてほぼ瞬時に計算可能である。リーズを拠点とするOptalysysは、オンチップのフーリエ変換コンポーネントをデータセンターのネットワークファブリックに直接統合している。創業者兼最高製品責任者のニック・ニュー氏は、受動的な光処理を光インターコネクト上に直接埋め込むことで、熱負荷を増加させることなく、AIワークロードのメモリバウンドなデコード段階に対処できると指摘した。テルアビブのスタートアップLightSolverは、ゲイン媒体を通じて刺激された光子を反射させるキャビティベースのレーザー処理ユニットを開発しており、エミュレーション試験においてGPUよりも40倍から8万倍高速に複雑な微分方程式を解くことに成功している。
こうした技術的な節目があるにもかかわらず、業界アナリストは、光コンピューティングが普及するには、主にアナログ・デジタル変換のオーバーヘッドとソフトウェアの慣性という高いハードルがあると強調する。イェール大学のローガン・ライト助教授(応用物理学)は、機械学習フレームワークが依然としてGPU向けに強く最適化されている現状を指摘する。しかし、NVIDIAやTSMCなどの主要チップメーカーが支援するコパッケージド・オプティクス(CPO)構想により、フォトニクスがハイパースケール施設に浸透するためのパッケージング基盤が確立される見通しだ。
業界幹部は、シリコンプロセッサを完全に置き換えるのではなく、ハイブリッドなコンピューティング・トポロジーが採用されると予想している。フェルトシュ氏は、将来の企業インフラは「システム管理のCPU、汎用ルーチンのGPU、電力負荷の高い線形代数や波動力学を担うフォトニック処理ユニット」という異種混在型アーキテクチャに依存するようになると予測している。
本記事は The OmniWire の編集基準に準拠して作成されています。一次報道は公式通信社の公表情報に基づいています。