Abrechnung bei KI-Investitionen: Die versteckte Inflation der Token-Ökonomie von Spitzenmodellen
Da CTOs durch ausschweifende Reasoning-Modelle wie Claude Fable 5.2 mit einem Kostenschock von 400 Prozent konfrontiert sind, verabschieden sich IT-Führungskräfte vom flächendeckenden Einsatz von Flaggschiff-Modellen und setzen verstärkt auf aggressives algorithmisches Modell-Routing.
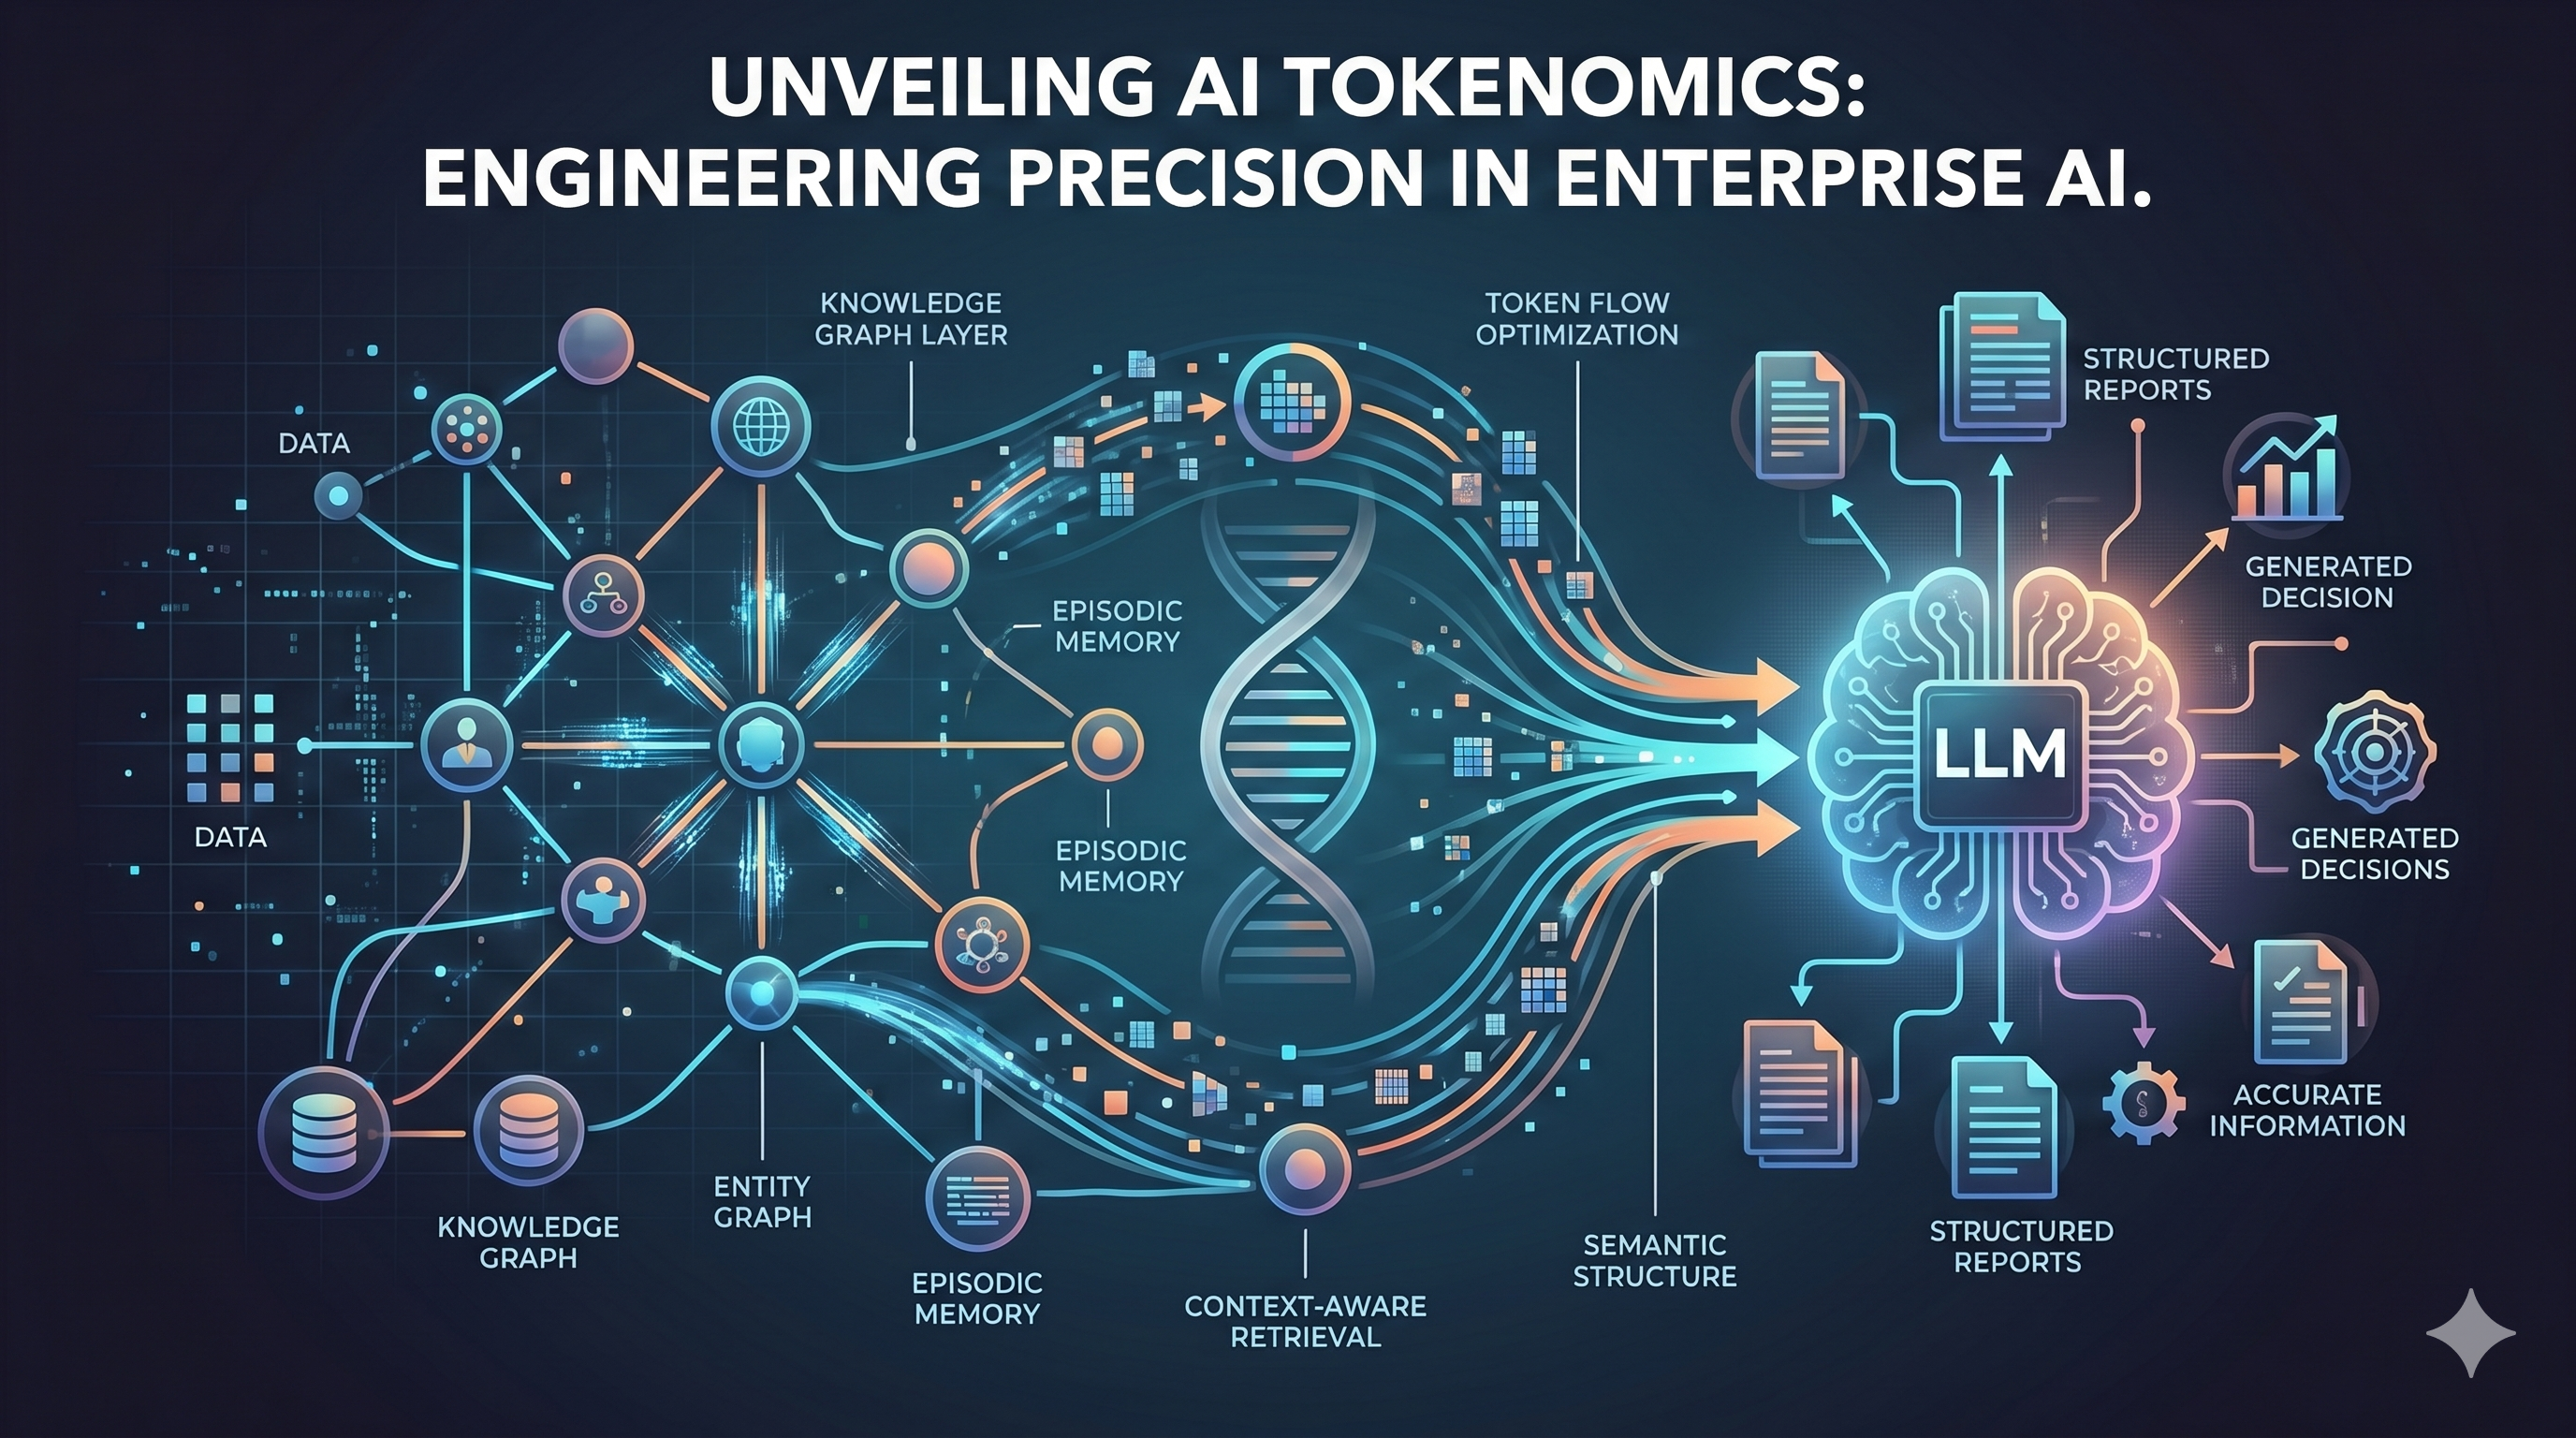
EXECUTIVE BRIEF // KERNPUNKTE
- •Schleichende Kosteninflation: Trotz um 20 Prozent gesenkter Listenpreise pro Token führen autonome Reasoning-Prozesse bei Modellen wie Claude Fable 5.2 zu einem Anstieg der realen API-Monatsrechnungen um 250 bis 400 Prozent.
- •Die „Thinking Tax“: Finanzanalysten beschreiben den massiven Mehrverbrauch durch rekursive, unaufgeforderte Denkschritte als verdeckte Steuer, die nominelle Preisvorteile vollständig aufzehrt.
- •Erodierende SaaS-Margen: B2B-Softwareanbieter mit Festpreis-Abonnements verzeichnen bei der Umstellung auf neue Spitzenmodelle teils dramatische Einbrüche ihrer Bruttomargen von 75 Prozent in den Verlustbereich.
- •Algorithmisches Modell-Routing als Standard: Unternehmen leiten mittlerweile 85 bis 90 Prozent der Routineaufgaben an kostengünstige Modelle wie Claude Opus 5.5 oder GPT-4o mini weiter und reservieren teure Reasoning-Systeme strikt für komplexe Haftungs- und Compliance-Fälle.
NEW YORK — Im gesamten Silicon Valley und in den IT-Abteilungen der Fortune-500-Konzerne sehen sich Technologievorstände mit einer beunruhigenden neuen Realität konfrontiert: Der unaufhaltsame Abwärtstrend bei den offiziellen Listenpreisen für KI-Tokens verschleiert eine beispiellose Welle schleichender Inflation bei den betrieblichen Aufwendungen für Unternehmens-KI.
Auslöser dieser aktuellen Ernüchterung ist die kommerzielle Einführung von Anthropics Claude Fable 5.2. Vermarktet mit einem aufsehenerregenden Preisnachlass von 20 Prozent auf die Token-Listenpreise im Vergleich zum Vorgängermodell, versprach das Flaggschiff-System den Chief Technology Officers eine höhere kognitive Leistungsfähigkeit bei geringeren Stückkosten. Stattdessen berichten erste Anwender am Monatsende von API-Abrechnungen, die bei routinemäßigen Entwickler-Workloads um 250 bis 400 Prozent in die Höhe geschnellt sind.
Die eigentliche Ursache liegt in einem Phänomen, das Finanzanalysten an der Wall Street als „Thinking Tax“ (Denksteuer) bezeichnen: dem explosiven Anstieg des Token-Verbrauchs durch autonome Reasoning-Modelle, die rekursiv abwägen und reflektieren, bevor sie eine endgültige Antwort ausgeben.
Die optische Täuschung der Preisdeflation pro Token
Zwei Jahre lang lieferten sich Hyperscale-KI-Anbieter einen erbitterten Preiskampf bei den Listenpreisen und senkten die nominellen Kosten für Eingabe- und Ausgabe-Tokens drastisch, um Marktanteile bei Unternehmensentwicklern zu gewinnen. Aktuelle Prüfungen von Venture-Capital-Portfolios in diesem Monat zeigen jedoch, dass die tatsächlichen KI-Verbrauchsmuster in Unternehmen stark von der Entwicklung der Listenpreise abweichen.
Während eine Million Tokens von Fable 5.2 im Eingang (Ingress) 8 US-Dollar und im Ausgang (Egress) 40 US-Dollar kosten – und damit rund das Doppelte des Tarifs von Claude Opus 5.5 –, ist das gesamte pro Aufgabe konsumierte Token-Volumen geradezu explodiert. Autonome Agenten, die auf Fable 5.2 basieren, verbrennen routinemäßig Zehntausende unaufgeforderter Reasoning-Tokens, um Spitzenwerte in Benchmarks zu erzielen, und machen damit jegliche vermeintliche Kosteneffizienz zunichte.
„Wir beobachten eine klassische Deflation der Stückpreise, gepaart mit einer massiven Inflation der verbrauchten Mengen“, erklärt Arthur Pendelton, leitender Stratege für Märkte und Unternehmenstechnologie bei The OmniWire. „Ein Anbieter kann seine nominellen Token-Preise um 20 Prozent senken; wenn sein Modell jedoch 350 Prozent mehr Tokens benötigt, um einen standardisierten Unternehmens-Workflow abzuschließen, vervierfacht sich die effektive Rechnung des Kunden nahezu. Für Anbieter von Cloud-Rechenleistung ist dies ein brillanter Monetarisierungsmechanismus, für die Finanzvorstände in den Unternehmen hingegen ein budgetärer Albtraum.“
Margendruck im B2B-SaaS-Sektor
Die finanziellen Folgen treffen insbesondere Software-Start-ups im Enterprise-Segment sowie B2B-SaaS-Anbieter mit voller Wucht. Zahlreiche Anwendungsentwickler bieten ihren Unternehmenskunden Festpreis-Abonnements an, während sie gleichzeitig die variablen Inferenzkosten der zugrunde liegenden Modelle über API-Aufrufe an Anthropic, OpenAI oder Google Cloud in der eigenen Bilanz absorbieren.
Wenn ein autonomes Tool zur Code-Überprüfung oder eine automatisierte Plattform für juristische Dokumentenanalysen (Legal Discovery) ihr Standard-Backend von Opus 5.5 auf Fable 5.2 umstellt, können die Bruttomargen bei intensiv genutzten Kundenkonten über Nacht von 75 Prozent in den negativen Bereich abstürzen.
„Wir mussten erleben, wie unsere Anthropic-API-Rechnung in einem dreiwöchigen Testlauf von 42.000 US-Dollar auf über 160.000 US-Dollar hochschoss – ohne jeglichen Anstieg bei den Werten zur Kundenzufriedenheit“, räumte der Vice President of Engineering eines Fintech-Infrastrukturanbieters der Series-C-Phase ein. „Die Ausgaben waren geringfügig ausführlicher, aber die funktionale Korrektheit war nicht von dem zu unterscheiden, was Opus 5.5 lieferte. Wir mussten die Integration innerhalb von 48 Stunden rückgängig machen.“
Der Aufstieg des algorithmischen Modell-Routings
Um die Unternehmensbilanzen vor einem unkontrollierten Token-Verbrauch zu schützen, kehren IT-Architekten dem universellen Einsatz einzelner Spitzenmodelle rasch den Rücken. Anstelle eines einzigen Frontier-LLM, das sämtliche Unternehmensanfragen bearbeitet, implementieren Entwicklerteams hochkomplexe, latenzbewusste Modell-Router.
In diesem mehrstufigen Paradigma leiten Organisationen 85 bis 90 Prozent der standardmäßigen Unternehmensanfragen, automatisierten Kundensupport-Vorgänge und routinemäßigen Aufgaben zur Code-Refaktorisierung an kosteneffiziente Arbeitspferde wie Claude Opus 5.5, GPT-4o mini oder lokal betriebene Open-Source-Modelle weiter. Lediglich die verbleibenden 10 Prozent der hochgradig mehrdeutigen und haftungsintensiven Aufgaben – wie etwa die Validierung neuartiger kryptografischer Verfahren oder komplexe Prüfungen zur Einhaltung regulatorischer Vorschriften (Compliance-Audits) – werden an Premium-Systeme wie Fable 5.2 eskaliert.
Während sich die Budgetzyklen der Konzerne im Vorfeld des Geschäftsjahres 2027 verschärfen, hat sich unter den Unternehmen ein klarer Konsens herausgebildet: Leistungsstarke Reasoning-Modelle müssen unter Beweis stellen, dass sich ihre kognitive Tiefe in einer messbaren Kapitalrendite (ROI) niederschlägt – andernfalls bleiben sie auf spezialisierte, streng reglementierte Nischen beschränkt.
Dieser Bericht wurde in Übereinstimmung mit den redaktionellen Standards von The OmniWire erstellt. Die primäre Berichterstattung stützt sich auf verifizierte Agenturmeldungen.